
算力租赁新纪元:英伟达 H20 驱动 GPU 集群与 AI 服务器升级
在数字化浪潮奔涌向前的当下,算力已然成为推动各行业发展的核心动力。如同工业时代的电力一般,算力为数据的处理、分析以及各类创新应用提供了必要的支撑。算力租赁作为一种创新的算力获取模式,正凭借其灵活性、高效性与成本效益,逐渐成为众多企业和开发者满足算力需求的首选途径,在市场中崭露头角,发展势头迅猛。
算力租赁:开启算力获取新模式
算力租赁,简单来说,就是企业或个人通过支付租金的方式,从专业的算力服务提供商处获取所需的计算资源。这一模式有效突破了传统算力获取方式的重重局限。在过去,企业若要构建自己的算力基础设施,不仅需要投入巨额资金用于购买硬件设备、建设机房,还需承担后续的运维成本以及设备折旧和技术更新的风险。而算力租赁模式的出现,为企业带来了曙光。它使得企业无需再进行大规模的前期投资,只需根据自身实际业务需求,灵活租赁相应的算力资源,真正实现了按需使用、按量付费。
这种模式不仅大幅降低了企业的算力使用门槛,还显著提高了资源的利用效率。例如,一些季节性业务的企业,在业务旺季时对算力需求大增,通过算力租赁能够迅速扩充算力;而在淡季,可减少租赁资源,避免资源闲置浪费。中小企业由于资金和技术实力相对薄弱,难以独立承担大规模算力建设的重任,算力租赁为它们提供了便捷、经济的算力解决方案,使其能够将更多资源聚焦于核心业务的创新与发展。
GPU 集群:算力租赁的中流砥柱
GPU 集群作为实现高性能计算的关键架构,在算力租赁场景中发挥着中流砥柱的作用。在 GPU 集群中,多个配备 GPU 的计算节点通过高速网络紧密相连,协同工作以处理复杂的计算任务。AI 领域,尤其是深度学习训练和推理任务,对计算能力有着极高的要求。以深度学习训练为例,训练一个复杂的神经网络模型需要处理海量的数据和进行极其复杂的数学运算,如大量的矩阵乘法和卷积运算等。单个 GPU 的计算能力虽然强大,但面对大规模的训练任务往往力不从心。而 GPU 集群则凭借其独特的并行计算架构,能够将这些复杂的矩阵运算任务分解为多个子任务,并同时分配到多个 GPU 核心上进行并行处理,从而极大地缩短了训练时间。相关研究表明,与传统的 CPU 计算相比,GPU 集群在处理深度学习矩阵运算任务时,计算速度可实现数量级的提升,能够将原本需要数周甚至数月完成的模型训练时间缩短至几天甚至数小时,为 AI 模型的快速迭代和优化提供了坚实有力的保障。
GPU 集群能够支持来自不同硬件供应商的硬件,如 AMD 和英伟达等,然而,英伟达凭借其在 AI 计算领域的先发优势、强大的技术研发实力以及广泛而完善的生态系统,在 GPU 集群市场中占据着举足轻重的地位。英伟达不仅推出了一系列性能卓越的 GPU 产品,如 A100、H100 等,还开发了专门针对 GPU 计算的 CUDA(Compute Unified Device Architecture)平台,为开发者提供了便捷高效的编程接口,使其能够充分利用 GPU 的并行计算能力,大大降低了开发难度,提高了开发效率。同时,主流的 GPU 集群编程模型,如 MPI(Message Passing Interface)+CUDA,为程序员提供了有效利用异构计算资源、充分发挥 GPU 集群多层次并行能力的途径,尽管这些编程模型在实际应用中存在一定的局限性,如编程复杂度较高、对开发者技术要求较高等,但它们仍能有力支撑各类并行计算任务的开发与执行。通过灵活扩增节点数量以及及时更新升级硬件设备,GPU 集群具备出色的可扩展性,能够从容应对不断增长的算力需求,为企业和科研机构提供持续稳定的强大计算支持。
AI 服务器:AI 应用的硬件基石
AI 服务器作为专门为 AI 应用量身定制的高性能硬件平台,融合了强大的计算能力、高速的数据传输和存储功能,是 AI 技术得以在实际场景中落地应用的关键支撑。它通常采用主流的可扩展处理器,并配备专业的 GPU 卡,为 AI 算法的运行构建了高效的并行计算环境。
在硬件配置方面,AI 服务器具备诸多独特之处。为了满足 AI 算法对计算能力的极高要求,AI 服务器往往搭载多个高性能 GPU,如英伟达的 A100、H100 甚至 H20 等芯片,这些 GPU 芯片能够提供强大的并行计算能力,加速 AI 模型的训练和推理过程。同时,AI 服务器配备了大容量的内存,用于存储和快速访问大规模的数据集和模型参数。以训练大型语言模型为例,这类模型往往包含数十亿甚至数万亿的参数,需要大量的内存来存储和处理,一些高端 AI 服务器配备了数 TB 的 DDR 内存,能够充分满足此类任务对内存的巨大需求。此外,高速存储设备也是 AI 服务器的重要组成部分,如 NVMe SSD,其具备极高的数据读写速度,能够显著减少数据加载时间,提高整体计算效率。在网络方面,AI 服务器通常采用高速网络接口,支持万兆甚至更高带宽的网络连接,确保数据在服务器内部以及与外部存储和其他服务器之间能够快速传输,满足 AI 应用对数据实时性的严格要求。
在软件层面,AI 服务器针对 AI 工作负载进行了深度优化。操作系统通常会采用专门定制的版本,以更好地支持 GPU 等硬件加速设备,优化资源调度和任务管理,确保系统能够高效稳定地运行。同时,AI 服务器会预装各种主流的深度学习框架和开发工具,如 TensorFlow、PyTorch、MXNet 等,以及相关的库和依赖项,方便开发者快速搭建开发环境,进行模型训练、推理等工作。此外,为了提高 AI 应用的安全性和可靠性,AI 服务器还配备了相应的安全软件和监控管理工具,能够对服务器的运行状态进行实时监测和维护,及时发现并解决潜在的问题,保障 AI 应用的持续稳定运行。
在实际应用中,AI 服务器广泛服务于人员管控、视频结构化、车辆分析等多种智能应用场景。在安防领域,AI 服务器能够实时对海量的监控视频进行分析,快速准确地识别人员身份、行为动作以及异常事件,为安全防范提供有力支持,极大地提高了安防工作的效率和准确性。在智能交通领域,AI 服务器可以对道路上的车辆进行实时监测、流量统计与违规行为抓拍等,通过对交通数据的实时分析和处理,优化交通信号控制,缓解交通拥堵,提升交通管理的智能化水平。这些应用都高度依赖 AI 服务器强大的计算能力,能够在短时间内处理大量的视频数据,并准确输出分析结果,为各行业的智能化发展提供了重要支撑。同时,AI 服务器具备良好的兼容性和扩展性,可以根据不同的应用需求灵活配置硬件和软件,适应不断变化的业务场景,具有极高的灵活性和适应性。
英伟达 H20:算力变革的新引擎
在此复杂严峻的国际形势下,英伟达为了继续服务中国市场,满足中国客户对 AI 芯片的迫切需求,推出了包括 H20 在内的三款针对中国市场的 AI 芯片。H20 芯片的诞生,无疑是英伟达在遵守相关规定的前提下,为中国市场精心打造的一款具有重要战略意义的产品,它为中国企业在受限环境下获取 AI 算力提供了可行的解决方案,也体现了英伟达对中国市场的重视以及积极应对挑战的策略。
H20 芯片采用英伟达先进的 Hopper 架构,该架构基于台积电 4N 工艺制造,内部集成了超过 800 亿个晶体管,并运用了五项突破性创新技术,为芯片在生成式 AI 训练和推理方面带来了显著的速度提升。同时,H20 芯片配备了 CoWoS(Chip On Wafer On Substrate)先进封装技术,这是一种 2.5 维的整合生产技术。其具体工艺为先将芯片通过 Chip on Wafer(CoW)的封装制程连接至硅晶圆,再把 CoW 芯片与基板(Substrate)连接,最终整合成 CoWoS。这种先进的封装技术有效提升了芯片的性能和稳定性,确保芯片在高负载运行环境下能够持续稳定地工作。
在算力方面,H20 芯片表现出色,其 FP8 算力达到 296TFLOPs,FP16 算力为 148TFLOPS,能够为各类 AI 任务提供强大的计算支持。在显存方面,H20 芯片也有显著提升,显存容量增大至 96GB HBM3,GPU 显存带宽达 4.0TB/s,这使得芯片在处理大规模数据时能够更加高效地进行数据读写和存储,避免了因显存不足或带宽瓶颈而导致的性能下降。并且,HGX H20 支持 NVLink 900GB/s 高速互联功能,采用 SXM 板卡形态,兼容英伟达 8 路 HGX 服务器规格,这些特性使其在垂类模型训练、推理等应用领域具有广阔的施展空间。虽然 H20 无法满足万亿级大模型训练需求,但整体性能略高于 910B,加上英伟达强大的 CUDA 生态,在市场中具备较强的竞争力。2024 年 5 月 24 日,媒体报道英伟达大幅削减供应中国市场的 H20 人工智能芯片价格,这一举措预计将进一步推动 H20 在算力租赁市场的普及,为更多企业和开发者提供高性价比的算力选择。
英伟达 SuperPOD:企业级 AI 的超级引擎
英伟达于 2024 年 3 月 GTC 大会上发布了基于全新 Blackwell 架构的新一代 AI 超级计算机 ——NVIDIA DGX SuperPOD。它专为企业级 AI 应用打造,可基于 NVIDIA DGX GB200 系统或 NVIDIA DGX B200 系统构建而成,为企业提供了强大且灵活的 AI 基础设施解决方案。
采用 DGX GB200 系统构建而成的 NVIDIA DGX SuperPOD 搭载 NVIDIA GB200 GraceBlackwell 超级芯片,是一台完整的数据中心级 AI 超级计算机,可用于处理万亿参数模型,能够保证超大规模生成式 AI 训练和推理工作负载的持续运行。该系统采用新型高效液冷机架级扩展架构,在 FP4 精度下可提供 11.5exaflops 的 AI 超级计算性能和 240TB 的快速显存,且可通过增加机架来扩展性能。每个 DGX GB200 系统搭载 36 个 NVIDIA GB200 超级芯片,共包含 36 个 NVIDIA GraceCPU 和 72 个 NVIDIA BlackwellGPU。这些超级芯片通过第五代 NVIDIA NVLink 连接成一台超级计算机。与 NVIDIA H100 Tensor Core GPU 相比,GB200 超级芯片在大语言模型推理工作负载方面的性能提升高达 30 倍。GraceBlackwell 架构的 DGX SuperPOD 由 8 个或以上的 DGX GB200 系统构建而成,这些系统通过 NVIDIA Quantum InfiniBand 网络连接,可扩展到数万个 GB200 超级芯片。用户可通过 NVLink 连接 8 个 DGX GB200 系统中的 576 块 Blackwell GPU,从而获得海量共享显存空间,来赋能下一代 AI 模型。
而采用 NVIDIA DGX B200 构建的 NVIDIA DGX SuperPOD,其中 DGX B200 是一款统一用于 AI 模型训练、微调和推理的通用 AI 超级计算平台。用户可以使用 DGX B200 系统构建 DGX SuperPOD,打造能够帮助大型开发团队运行多种不同作业的 AI 卓越中心。采用风冷传统机架式设计的 DGX 已被全球各行各业数千家企业广泛采用,DGX B200 是 DGX 系列的第六代产品。采用 Blackwell 架构的全新 DGX B200 系统包含 8 个 NVIDIA B200 Tensor Core GPU 和 2 个第五代英特尔 ® 至强 ® 处理器。DGX B200 系统包含带有 8 个 NVIDIA ConnectX™ - 7 网卡和 2 个 BlueField - 3 DPU 的高性能网络,每个连接的带宽高达 400GB/s,可通过 NVIDIA Quantum - 2 Infiniband 和 NVIDIA Spectrum™ - X 以太网网络平台支持更高的 AI 性能。DGX B200 系统凭借全新 Blackwell 架构中的 FP4 精度特性,可提供高达 144petaflops 的 AI 性能、1.4TB 海量的 GPU 显存和 64TB/s 的显存带宽,从而使得该系统的万亿参数模型实时推理速度比上一代产品提升了 15 倍。
所有 NVIDIA DGX 平台均包含用于企业级开发和部署的 NVIDIA AI Enterprise 软件。DGX 用户可以通过使用该软件平台中的预训练的 NVIDIA 基础模型、框架、工具套件和全新 NVIDIA NeMo 微服务来加速他们的工作。NVIDIA DGX 专家与部分获得 NVIDIA DGX 平台支持认证的合作伙伴将在每个部署环节为用户提供帮助,以便其迅速实现 AI 投产。在系统投入运行后,DGX 专家还将继续协助用户优化其 AI 管线和基础设施。
协同发展:推动算力租赁行业迈向新高度
英伟达 H20 芯片、GPU 集群、AI 服务器以及英伟达 SuperPOD 在算力租赁行业中并非孤立存在,而是相互协同,共同推动行业的发展。
英伟达 H20 芯片作为核心计算单元,为 GPU 集群和 AI 服务器提供了强大的底层算力支持。其先进的架构和性能特性,使得基于它构建的 GPU 集群和 AI 服务器在处理 AI 任务时具有更高的效率和性价比。GPU 集群则通过整合多颗 H20 芯片的算力,构建起强大的并行计算网络,满足大规模、复杂 AI 任务的计算需求,无论是深度学习训练还是实时推理,都能高效完成。而 AI 服务器作为硬件与软件的集成载体,将 H20 芯片和 GPU 集群有机结合,并通过优化的硬件架构和软件系统,为用户提供便捷、稳定的算力服务。英伟达 SuperPOD 则为企业级用户提供了一站式的超大规模 AI 计算解决方案,整合了强大的计算、存储、网络和软件资源,能够满足企业在处理最复杂 AI 工作负载时的需求。
在算力租赁市场中,这些组件的协同作用使得租赁商能够为客户提供多样化、定制化的算力解决方案。客户可以根据自身业务规模、应用场景以及预算,选择租用不同配置的 AI 服务器、GPU 集群资源,甚至是英伟达 SuperPOD 系统,以满足其在 AI 模型训练、数据分析、智能应用开发等方面的需求。这种协同模式不仅降低了客户使用算力的门槛和成本,也加速了 AI 技术在各行各业的普及和应用。
随着 AI 技术的不断发展,对算力的需求将持续增长。英伟达 H20 芯片、GPU 集群、AI 服务器以及英伟达 SuperPOD 将在技术创新和市场应用方面不断演进。未来,我们有望看到 H20 芯片在性能上进一步提升,GPU 集群的规模和效率不断优化,AI 服务器的功能更加丰富和智能化,英伟达 SuperPOD 能够支持更复杂、更大规模的 AI 应用。它们的协同发展将为算力租赁行业注入源源不断的动力,推动其在数字化时代发挥更大的价值,助力各行各业实现智能化转型与升级。
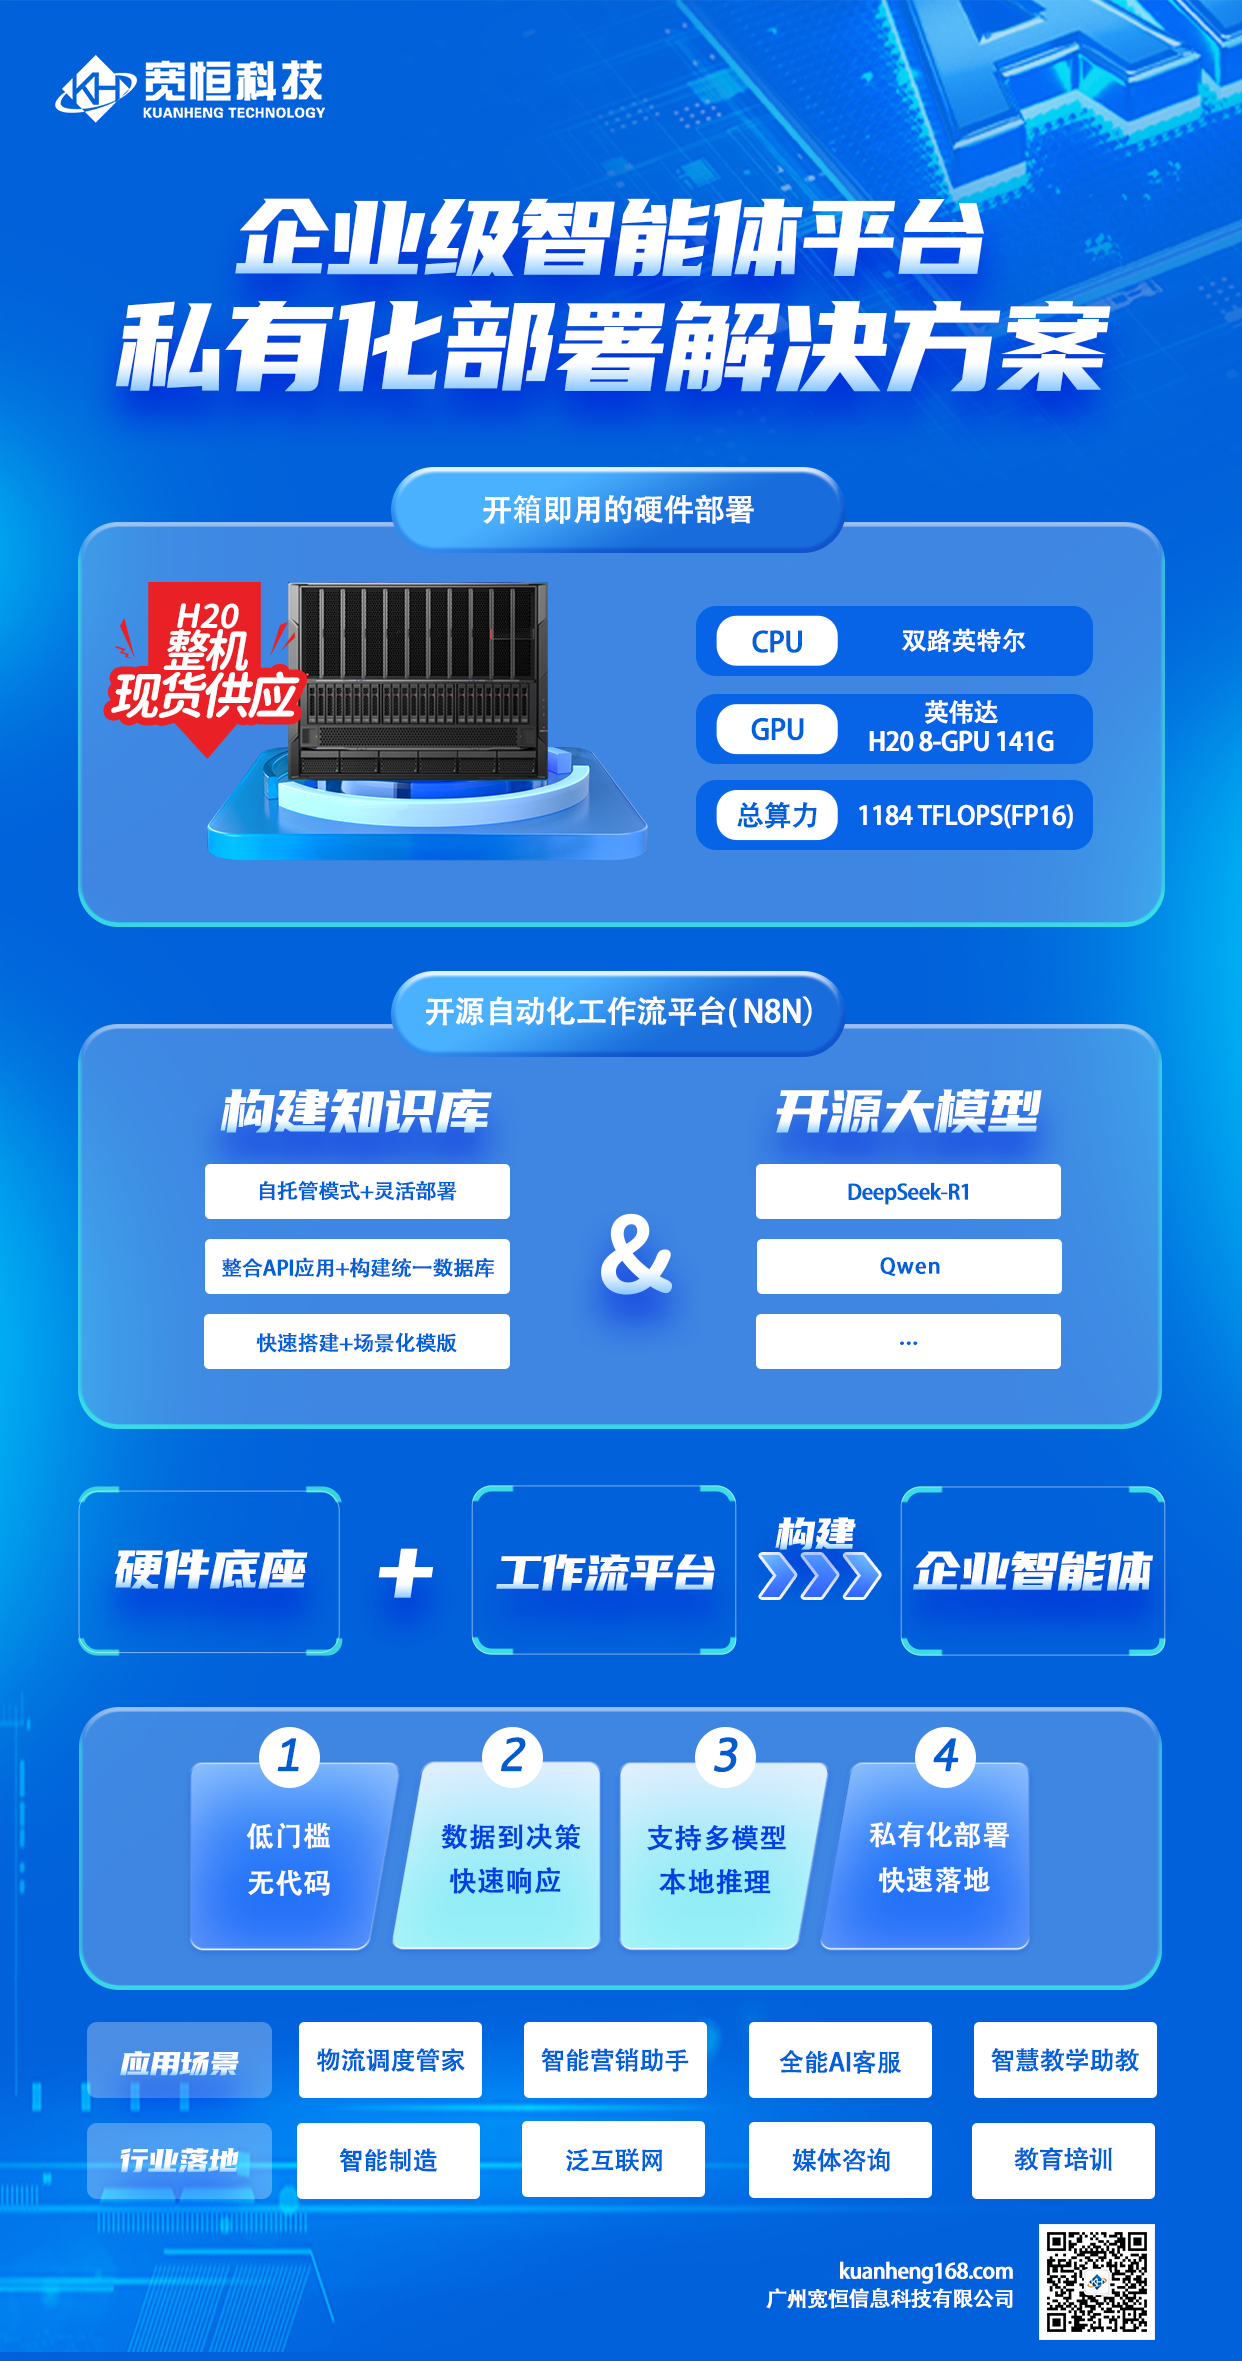
更多N8N+DeepSeek一体机配置请查看:https://www.kuanheng168.com/agent
企业构建知识库+落地智能体解决方案请查看:https://www.kuanheng168.com/agent
-
专业算力再进化:宽恒科技携手 RTX PRO 5000 Blackwell 深耕行业市场
当 AI 从云端走向桌面,专业显卡正迎来新一轮黄金周期。今年春季 GTC 大会上,NVIDIA 正式发布 RTX PRO 5000 Blackwell 专业显卡,凭借 Blackwell 架构与 48GB/72GB 超高速 GDDR7 显存,一经亮相便成为工作站市场的焦点;10 月 20 日,高盛再度上调全球 AI 服务器出货预测,AI 算力需求的旺盛可见一斑 —— 而在个体与团队层面,越来越多设计师、工程师与 AI 开发者,正在把 "专业算力" 作为生产力的核心投资。专业显卡市场,正从幕后走向台前。
넶0 2026-10-20 -
桌面上的 AI 超算:宽恒科技解析 NVIDIA DGX Spark 的应用之道
AI 算力的形态,正在发生一场 "下沉" 革命。10 月 2 日,NVIDIA 发布 DGX Spark 64GB,为开发者提供更多方式构建和扩展本地 AI;而在年初的 CES 2026 上,NVIDIA DGX Spark 驱动机器人 Reachy Mini 在展台与观众实时互动,把 "桌面级 AI 超算" 的想象力具象化。就在同一时期,全球首部面向智能体安全的强制性国家标准正式立项,AI 智能体从实验室走向生产环境已成定局。当智能体成为新的软件形态,一个现实问题浮出水面:海量的本地推理与智能体运行,是否都要依赖云端?NVIDIA DGX Spark 给出的答案是 —— 把 AI 超算放进桌面。
넶0 2026-10-20 -
PICO 4 Ultra 与 PICO OS 6 共舞,宽恒科技带您进入空间计算新时代
空间计算的浪潮,正从概念走向现实。2026 年下半年,PICO 接连放出重磅消息:面向开发者先行提供下一代操作系统 PICO OS 6,并预告代号 "Project Swan" 的新一代旗舰 XR 硬件将在全球发布,其超高精显示屏达到约 4000PPI 的量级,引发行业广泛关注。与此同时,PICO 4 Ultra 作为当前在售的主力 MR 一体机,凭借成熟的硬件与不断进化的软件生态,依然是大众体验空间计算的最佳入口之一。从娱乐到办公,从教育到行业应用,以 PICO 4 Ultra 为代表的 MR 设备,正在重新定义人与数字世界的交互方式。
넶0 2026-10-20 -
英伟达 NPN 生态扩容,宽恒科技深耕英伟达代理与合作伙伴服务
英伟达的生态版图正在加速扩张。8 月 31 日,英伟达宣布与 MediaTek 深化长期合作,共同构建从边缘到云端的 AI 计算平台,MediaTek 将采用全新的 NVLink Fusion 平台,帮助客户将定制 XPU 引入机架级 AI 工厂;10 月 14 日,英伟达又携手应用材料、Cadence、KLA、Lam Research、西门子、新思科技等半导体领军企业,推动 AI 在芯片设计与制造全流程落地。一连串动作背后,是英伟达从 "卖芯片" 向 "卖生态" 的战略深化 —— 而承载这一战略的市场通道,正是不断升级的 NVIDIA Partner Network(NPN,英伟达合作伙伴网络)。
넶0 2026-10-20 -
算力租赁驶入快车道,宽恒科技以 GPU 集群与 AI 服务器构筑算力新基建
刚刚过去的十月,算力市场再迎重磅消息。10 月 20 日,高盛大幅上调全球 AI 服务器出货预测,预计 2026 至 2028 年八卡 AI 服务器出货量将分别达到 173 万台、265.5 万台与 330.5 万台,隐含的 AI 芯片需求逼近两千万颗量级。来自中国信通院的另一组数据更加直观:2026 年一季度,国内算力租赁市场规模已达 680 亿元,全年预计突破 2600 亿元;同期国内 AI 算力需求同比大增 417%,而供给增速仅有 128%。需求狂奔、供给承压,"算力焦虑" 正从科技圈蔓延至千行百业。与此同时,政府工作报告明确部署超大规模智算集群、算电协同等新基建工程,一场围绕算力资源的产业变革正加速上演。
넶0 2026-10-20 -
宽恒科技:英伟达显卡总代视角下的 RTX PRO 5000 Blackwell
2026 年,AIGC 工作流已经深入设计、影视、工业与科研的每一个角落。Stable Diffusion 出图、本地大模型推理、数字孪生渲染…… 这些负载对显卡的显存容量与计算性能提出了前所未有的要求,专业显卡市场随之迎来一轮 “大显存、高算力” 的升级潮。在这一轮升级中,英伟达 Blackwell 架构的 RTX PRO 5000 专业显卡成为工作站用户关注的焦点,也让 “专业卡替代游戏卡跑生产负载” 成为行业讨论的常驻话题。
넶2 2026-10-19


